Populatte
SaaS B2B que preenche formulários web a partir de planilhas de Excel: dashboard, API e extensão de navegador, com um humano no comando.
A frase que eu disse com confiança demais
Uma amiga tem uma empresa de mineração. Boa parte do trabalho administrativo dela é passar dados para formulários do governo, naqueles portais antigos que parecem feitos sem pensar em quem vai ficar digitando do outro lado. Numa conversa, soltei a frase clássica de quem programa: "isso não deve ser difícil, é só fazer um robô que preenche os campos".
Aí eu abri os formulários.
Não era um formulário: eram vários, encadeados, alguns recarregando a página inteira a cada campo preenchido. E os dados não estavam numa planilha comportada, com uma linha por registro e um cabeçalho no topo. Estavam espalhados por várias planilhas, cada uma organizada do seu jeito: uma matriz com os meses do ano na lateral, uma aba onde cada linha era um campo em vez de um registro, células soltas servindo de configuração, abas que nem entram no preenchimento e existem só porque alguém um dia precisou conferir uma conta.
A parte de preencher o campo é de longe a mais fácil. O problema de verdade eram duas perguntas: o que essa planilha quer dizer? e para onde vai cada valor no formulário? Ou, na minha cabeça de programador: como eu mapearia os dados da planilha para o formulário?
O Populatte nasceu daí, em meados de 2025. O nome é populate + latte: a ideia é inverter o papel do café no escritório. Em vez de ser o combustível para virar a noite digitando, ele volta a ser só um café, tomado com calma enquanto o trabalho chato acontece sozinho.
O que ele faz
Um dashboard web onde você cria um projeto, sobe as planilhas e diz o que cada coluna significa. Uma extensão de navegador que, no site de destino, aprende onde cada valor vai: você clica na coluna, clica no campo, e isso vira uma receita salva. Depois é registro a registro: a extensão preenche, você confere e envia.
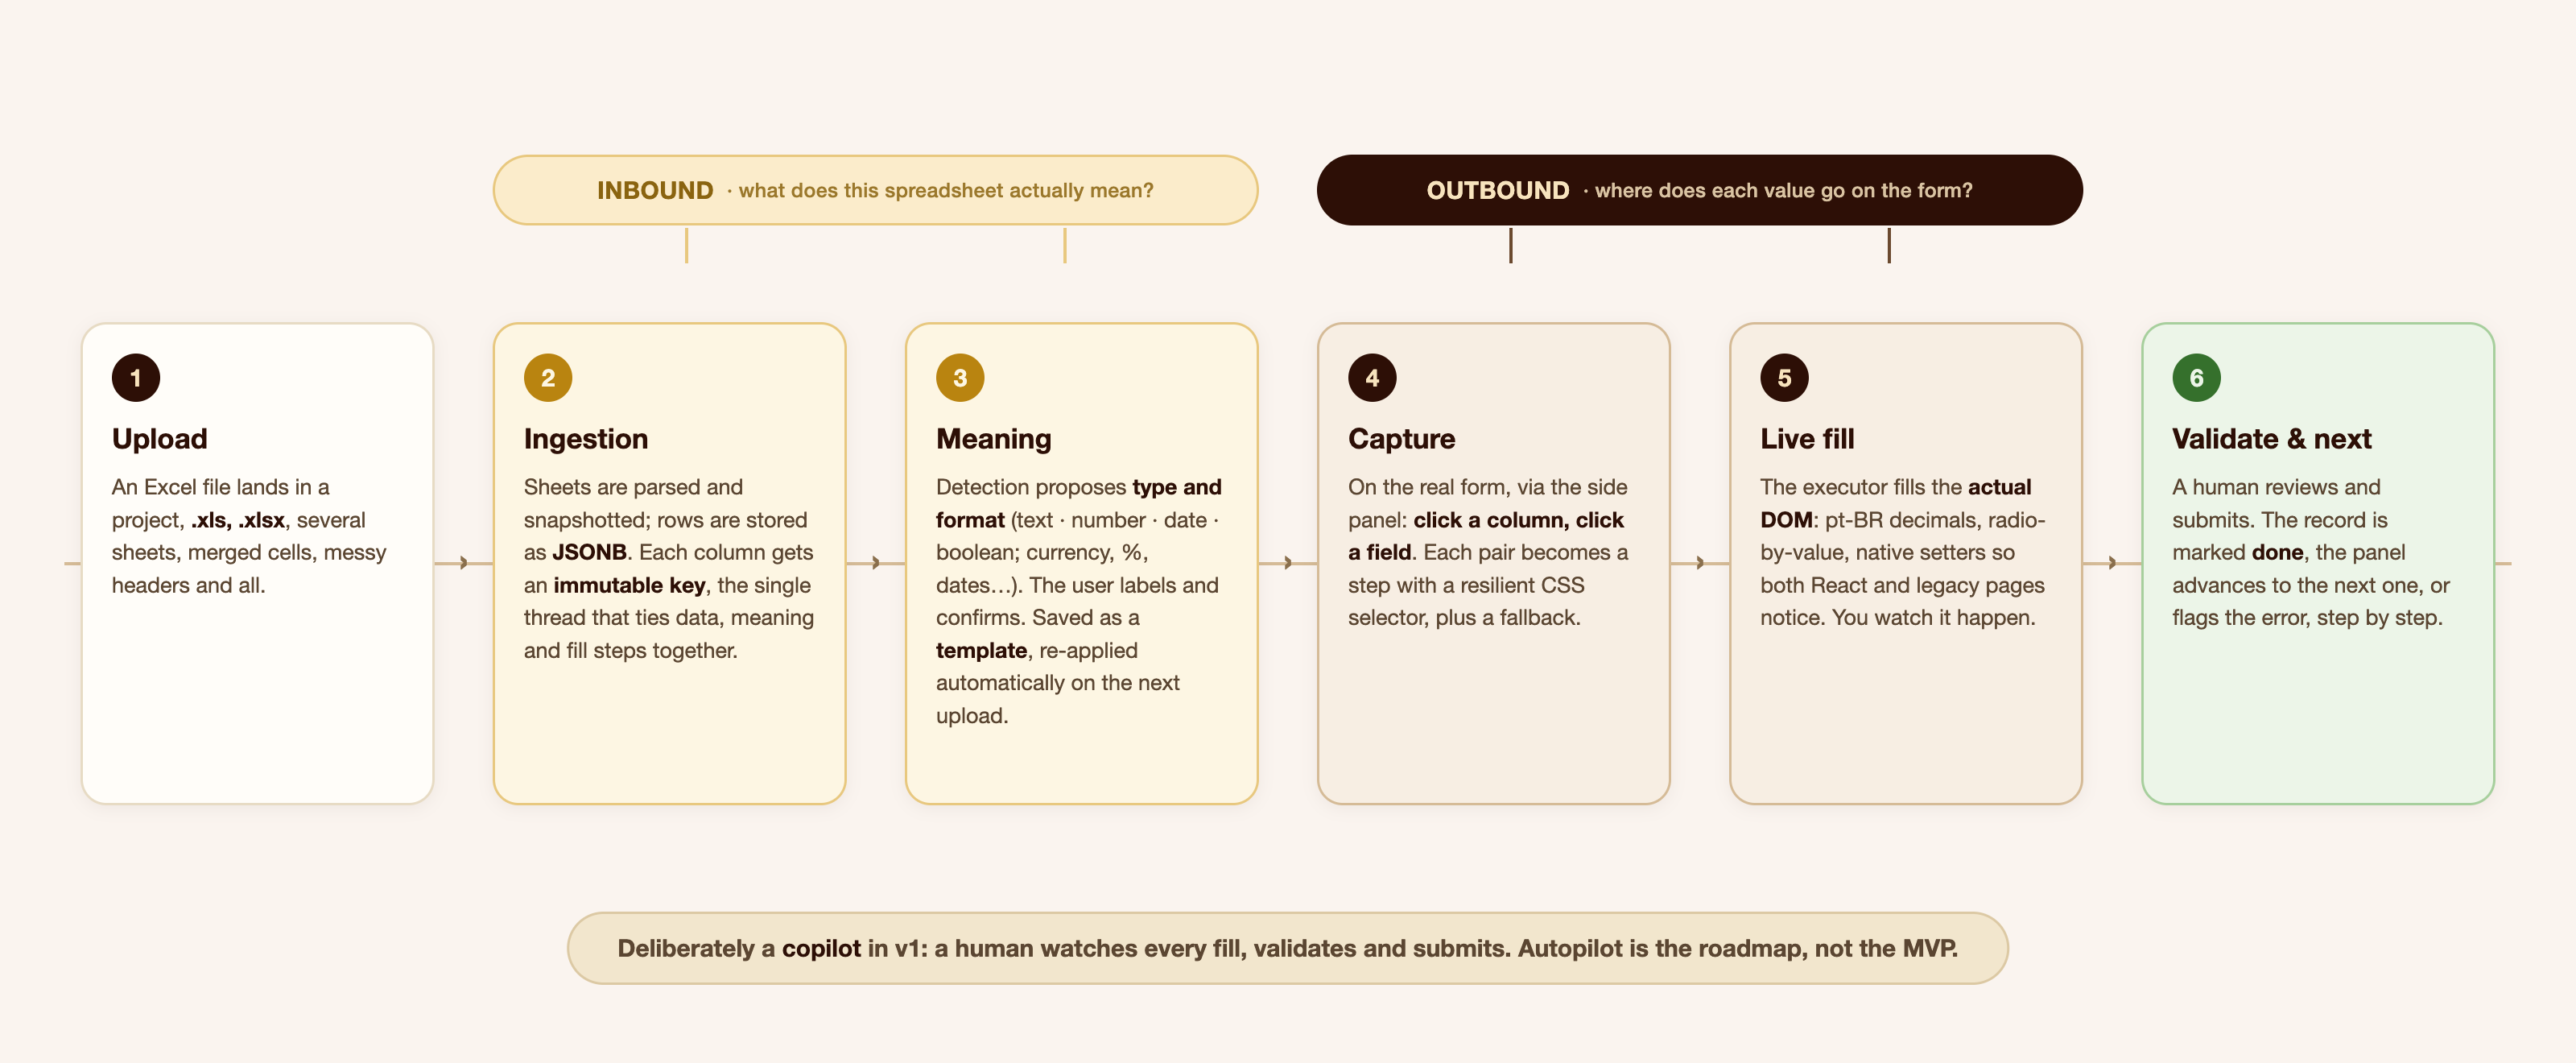
Repare na divisão do diagrama, porque ela é a decisão de arquitetura mais importante do projeto. Existem dois mapeamentos, não um. O inbound responde "o que é este dado" e vive na planilha. O outbound responde "onde ele vai" e vive no formulário. Tratar os dois como a mesma coisa é o erro que derruba esse tipo de ferramenta na segunda planilha: você acaba com um vínculo direto entre a célula B7 e o campo #txtProducao, e basta alguém inserir uma linha no Excel para tudo quebrar em silêncio. Que é o pior jeito de quebrar, porque o formulário é enviado mesmo assim, só que errado.
Por que copiloto, e não piloto automático
A pergunta óbvia: se dá para preencher, por que não preencher tudo sozinho, sem humano nenhum?
Por dois motivos, e o primeiro é segurança. Esses dados não são triviais. São dados fiscais e operacionais de uma empresa indo para um portal do governo, e enviar é um ato com consequência. Eu não quero que a primeira versão de um sistema meu aperte esse botão. O segundo motivo é que eu quero que o Populatte sirva para qualquer formulário, de qualquer setor, e não só para os que eu já vi. Para isso alguém precisa ensinar o caminho pelo menos uma vez, e a única forma honesta de aprender é a pessoa abrir a página e apontar: este dado vai neste campo.
Então a v1 é assumidamente um copiloto. A extensão preenche, a pessoa valida e envia, e o registro é marcado. Depois que muitos caminhos estiverem gravados, a automação total vira um passo pequeno em vez de um salto de fé.
A arquitetura
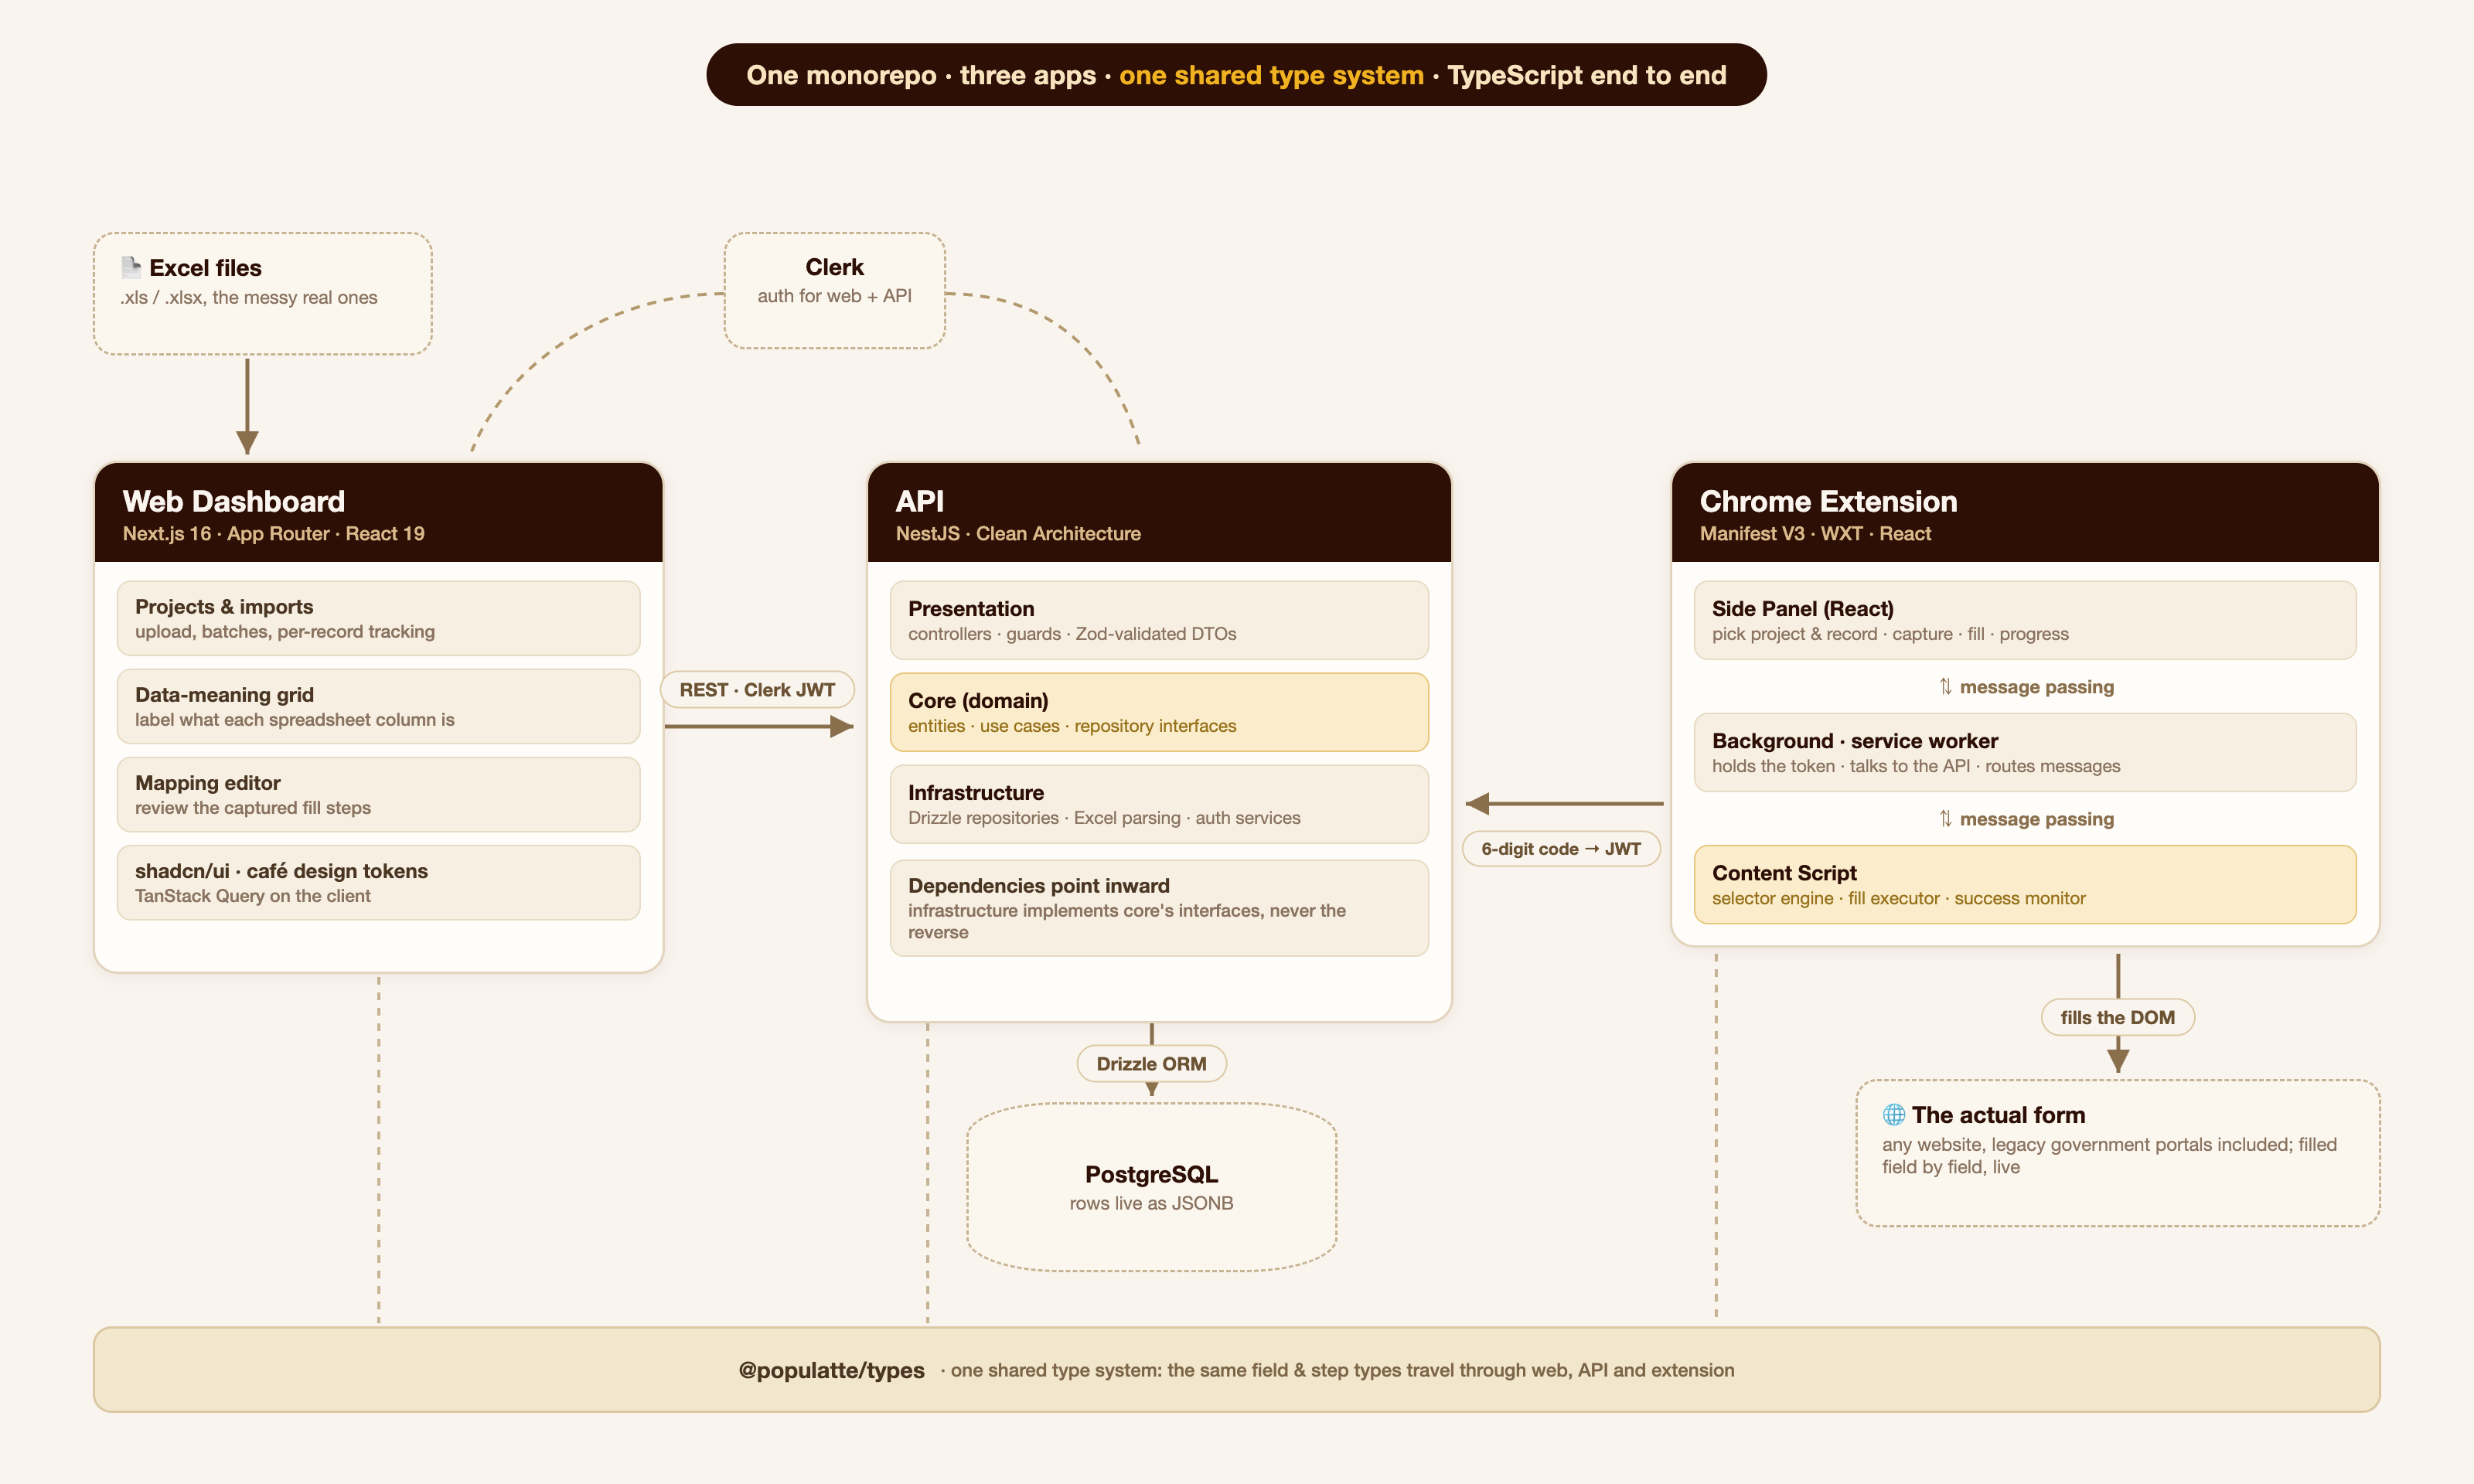
Três aplicações num monorepo, tudo em TypeScript, com um pacote de tipos compartilhado no meio. Esse pacote importa mais do que parece: o tipo de um campo (o que ele é, de onde vem o valor, como deve ser escrito) é definido uma vez só e atravessa as três aplicações. Quando eu mudo esse contrato, o compilador aponta todos os lugares que precisam mudar junto, inclusive dentro da extensão. Já estou no segundo modelo de dados grande desse projeto, e sem isso cada mudança viraria uma caçada pelo repositório inteiro.
O dashboard
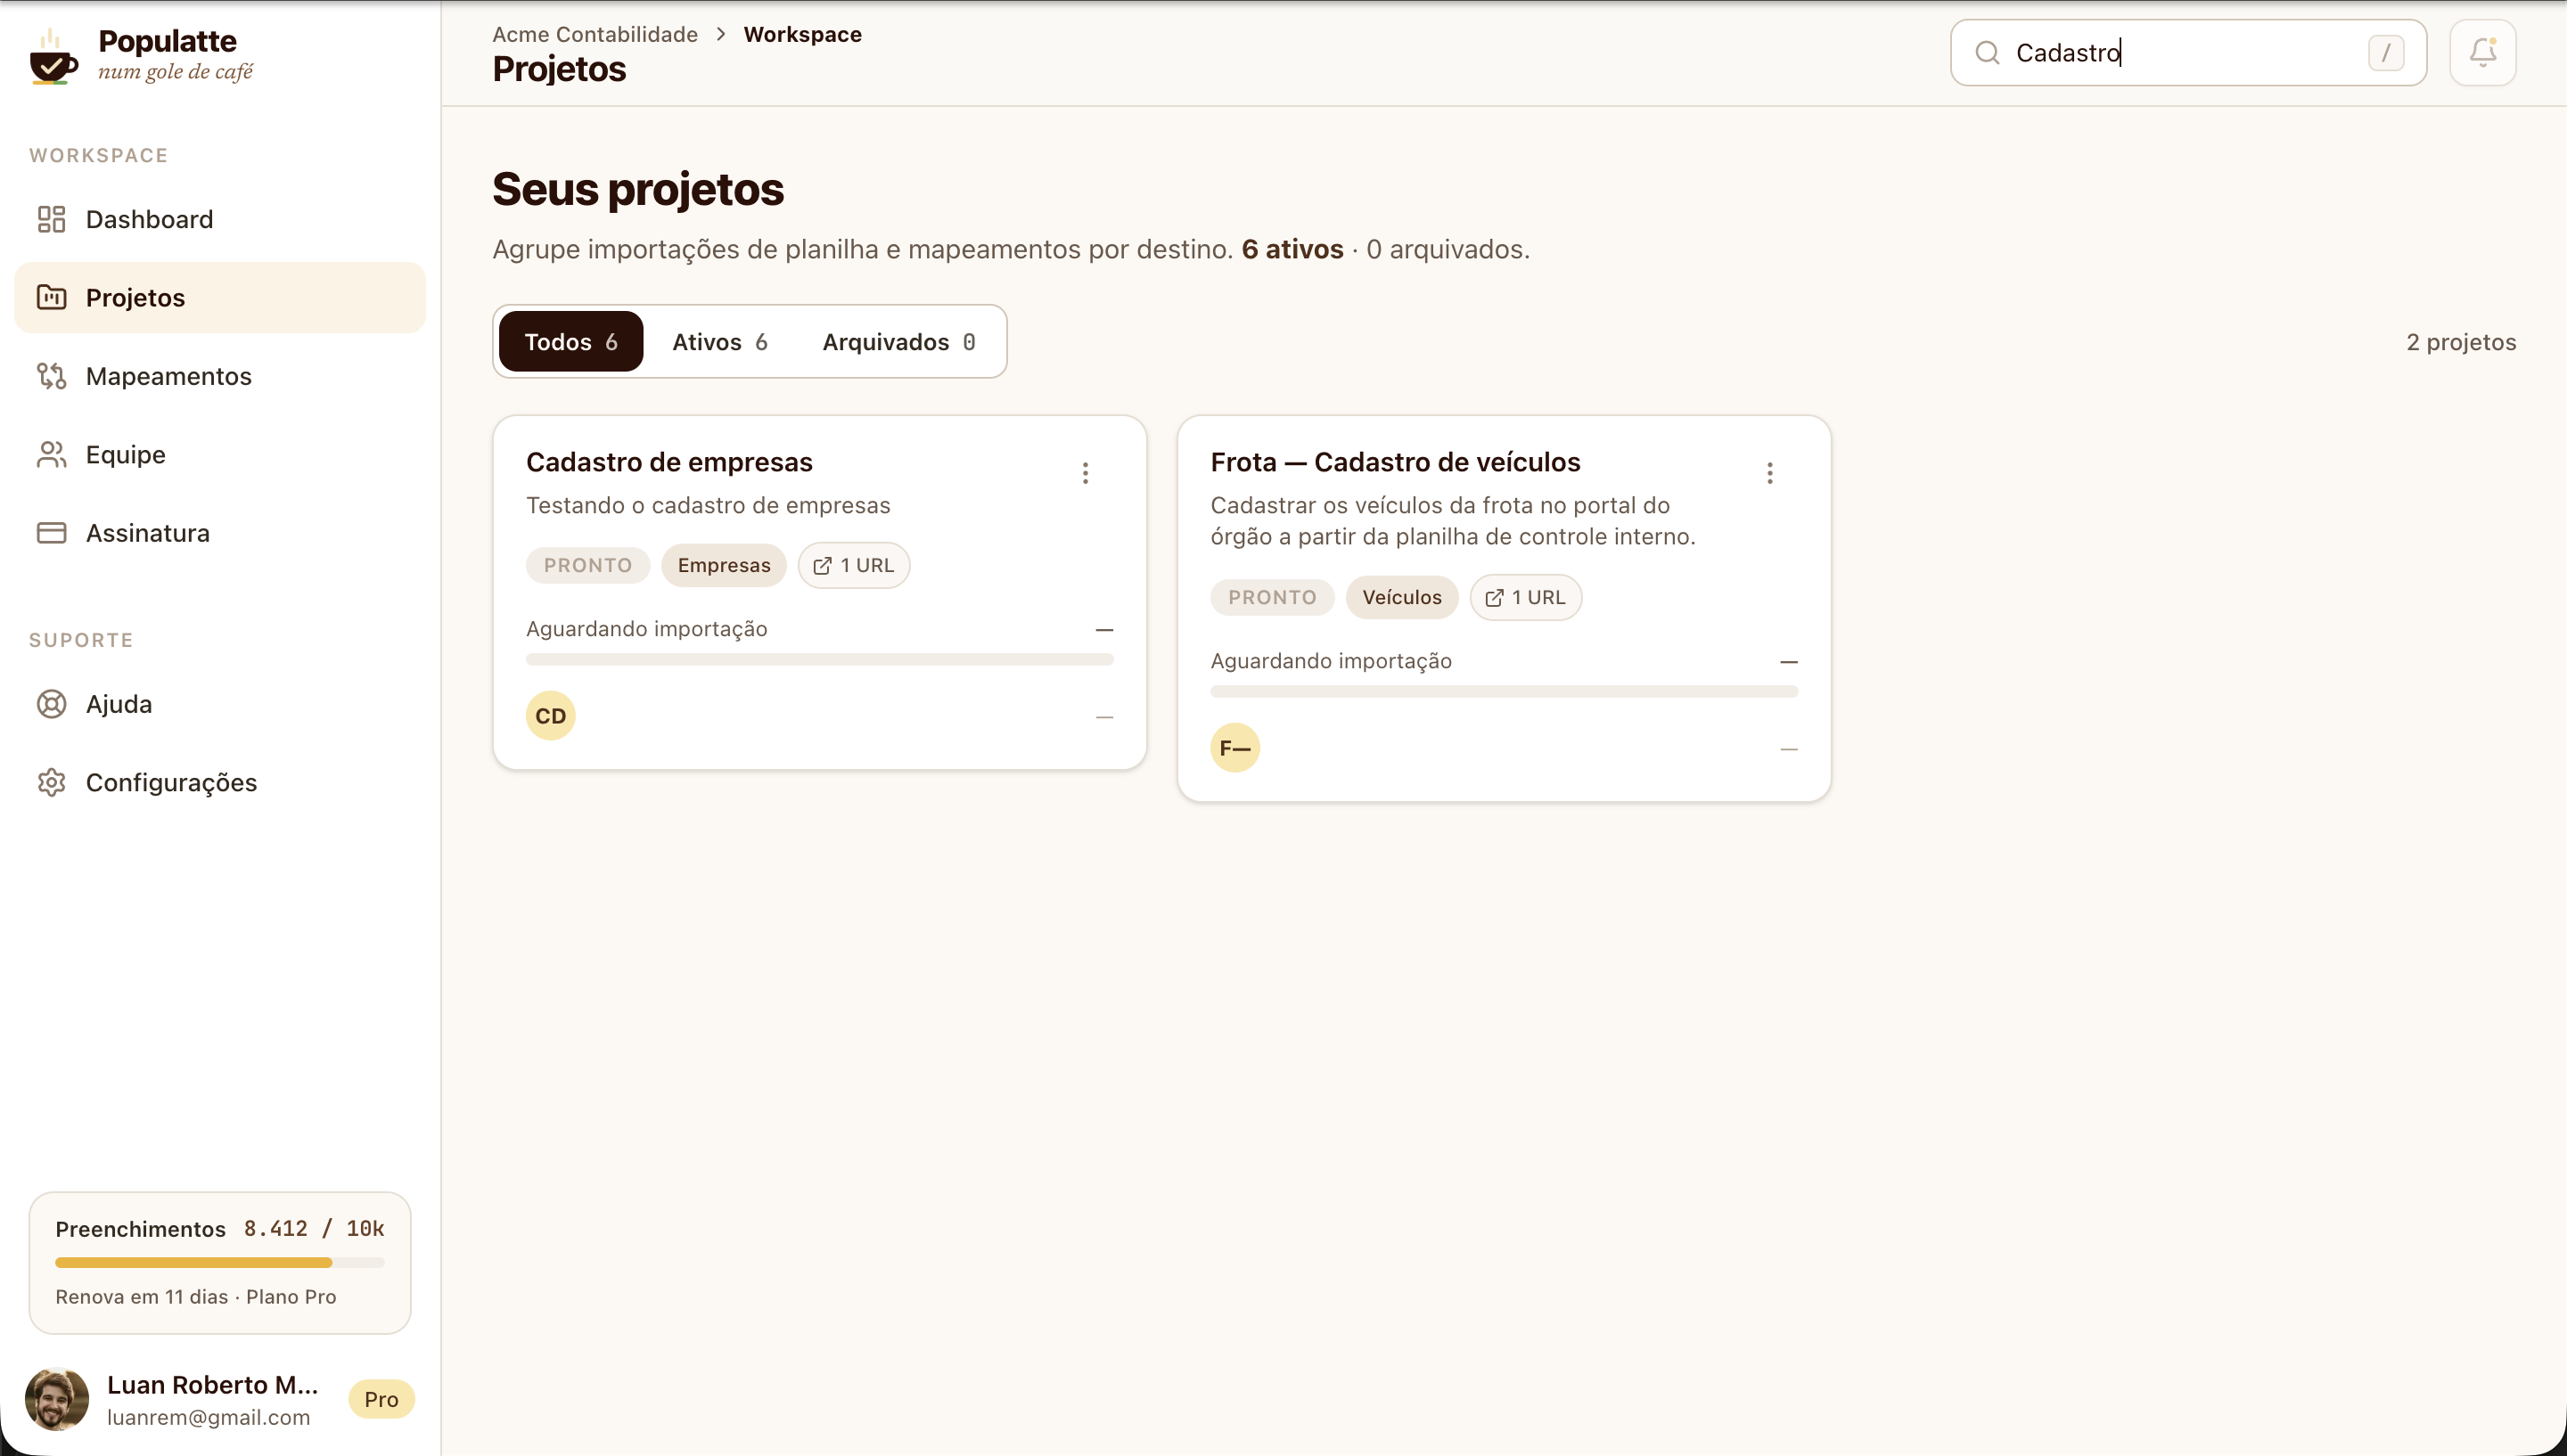
Next.js 16 com App Router e React 19, TanStack Query no cliente, shadcn/ui em cima de Tailwind. A parte que eu mais gosto nem é tecnologia: é o tema viver inteiro em tokens. Os marrons de espresso, o dourado do botão de preencher, as cores de status do ciclo de preenchimento, tudo tem nome e mora num lugar só. Nenhum componente conhece uma cor.
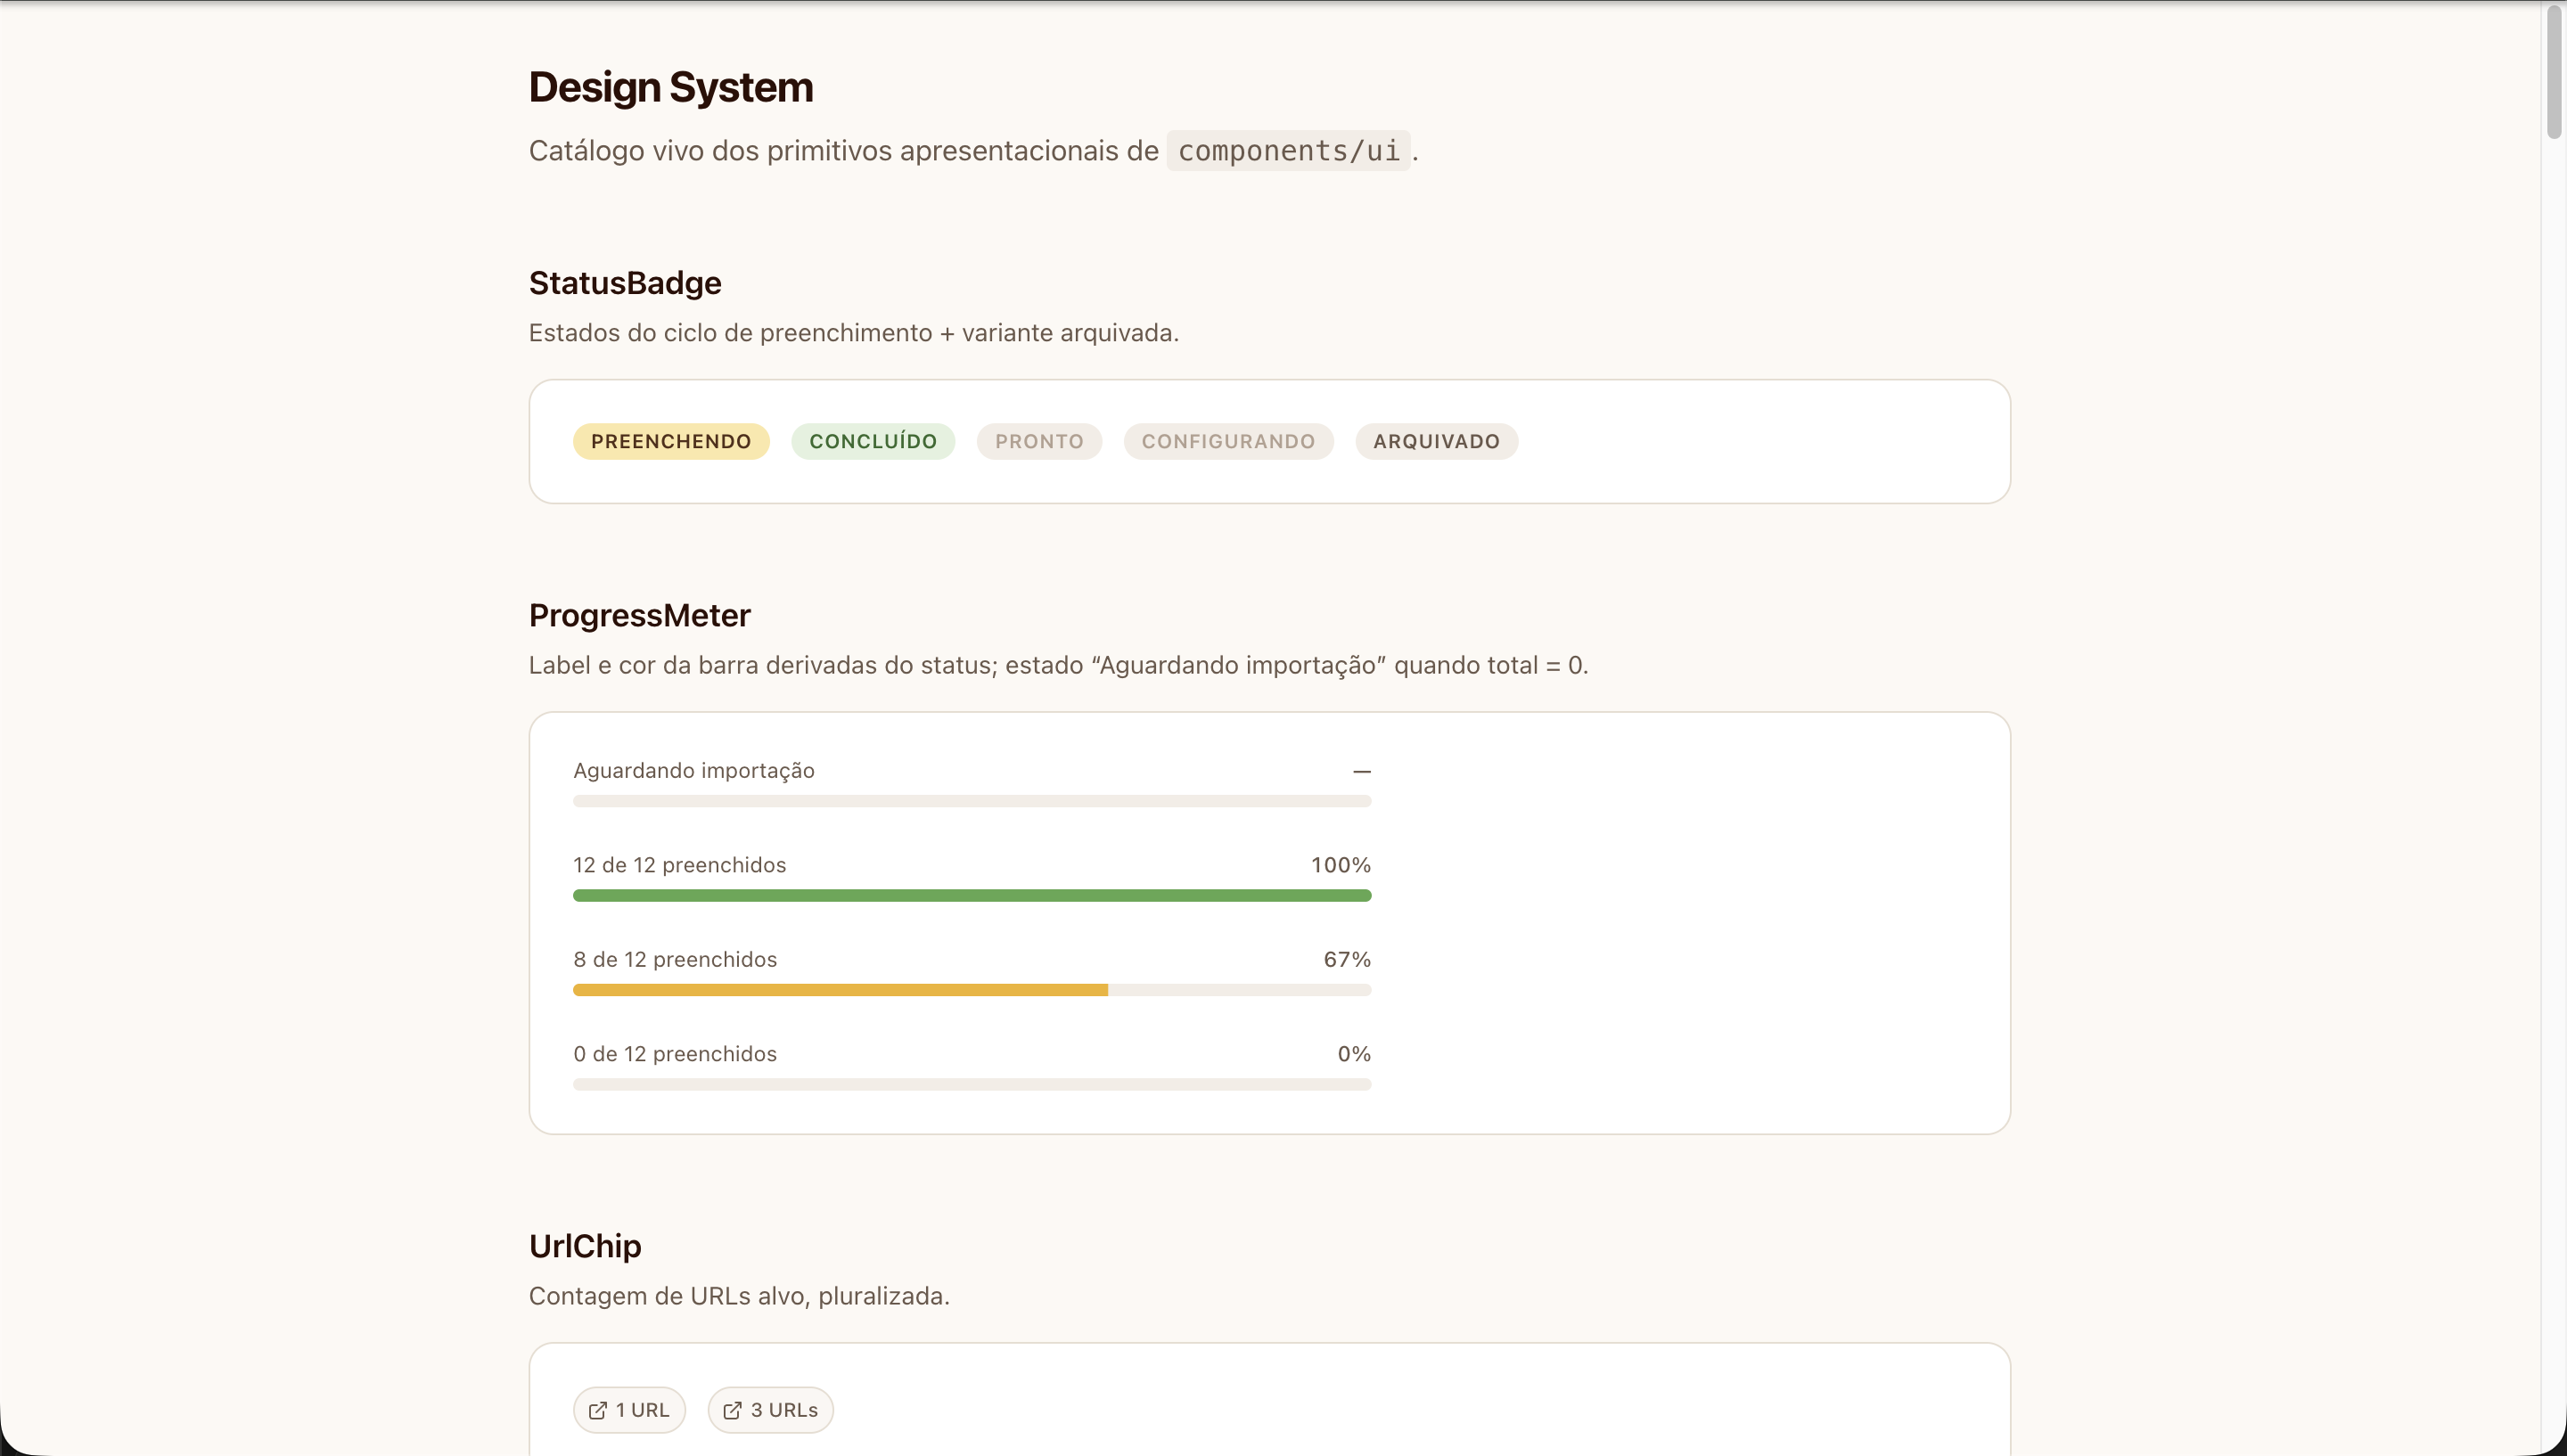
Existe uma página /design-system que mostra cada primitivo com todas as variações, e ela é a referência para qualquer tela nova.
Clerk cuida da autenticação, e essa foi uma escolha de foco: autenticação é problema resolvido, e eu preferia gastar meu tempo no problema que ninguém resolveu ainda.
A API
NestJS, com Clean Architecture de verdade: core, infraestrutura e apresentação. Num projeto pessoal isso parece exagero, e foi escolha consciente. O NestJS já te empurra para um código bem organizado desde o começo, e como eu pretendo que esse projeto sobreviva por vários anos e passe por mudanças grandes de modelo de dados, preferi pagar a estrutura adiantado a pagar a manutenção depois. O núcleo do domínio não conhece banco, não conhece HTTP, não conhece Drizzle: ele declara interfaces de repositório e a infraestrutura que se vire para implementá-las.
Isso se pagou nos momentos de refatoração. Quando troquei todo o vocabulário de tipos dos campos, as regras importantes estavam num punhado de arquivos de domínio, testáveis sem subir nada. (E existe uma violação da regra de dependência que eu ainda não paguei: um caso de uso do core importa o serviço de ingestão da infraestrutura. Eu sei que ela está lá, está no backlog, e prefiro registrar isso aqui do que fingir que está tudo perfeito.)
Os dados de cada linha da planilha ficam em JSONB no PostgreSQL, com Drizzle por cima. Zod valida tudo que entra, e num ponto específico ele faz mais que validação: o schema que aceita edições de campo é estrito, então qualquer tentativa de mandar um atributo que deveria ser imutável é rejeitada na borda da API, e não três camadas depois. Arquivos enviados são conferidos pelos magic bytes de verdade (um .xlsx é um ZIP, um .xls antigo é um contêiner OLE2), porque confiar na extensão do arquivo é confiar no nome que o usuário deu para ele.
A extensão
Manifest V3, construída com WXT, com a interface em React no Side Panel do Chrome, não num popup. Essa diferença importa mais do que parece: um popup fecha na hora em que você clica na página, que é exatamente o momento em que você precisa dele aberto para apontar um campo.
O Manifest V3 obriga a viver em três contextos isolados que não compartilham memória: o painel (interface), o service worker de fundo (token, chamadas de API, estado por aba) e o content script, o único que toca o DOM da página. Tudo entre eles é troca de mensagens tipada. E o service worker pode ser morto pelo navegador a qualquer momento, então nada importante pode viver só na memória dele.
A parte difícil não é preencher
Entender a planilha
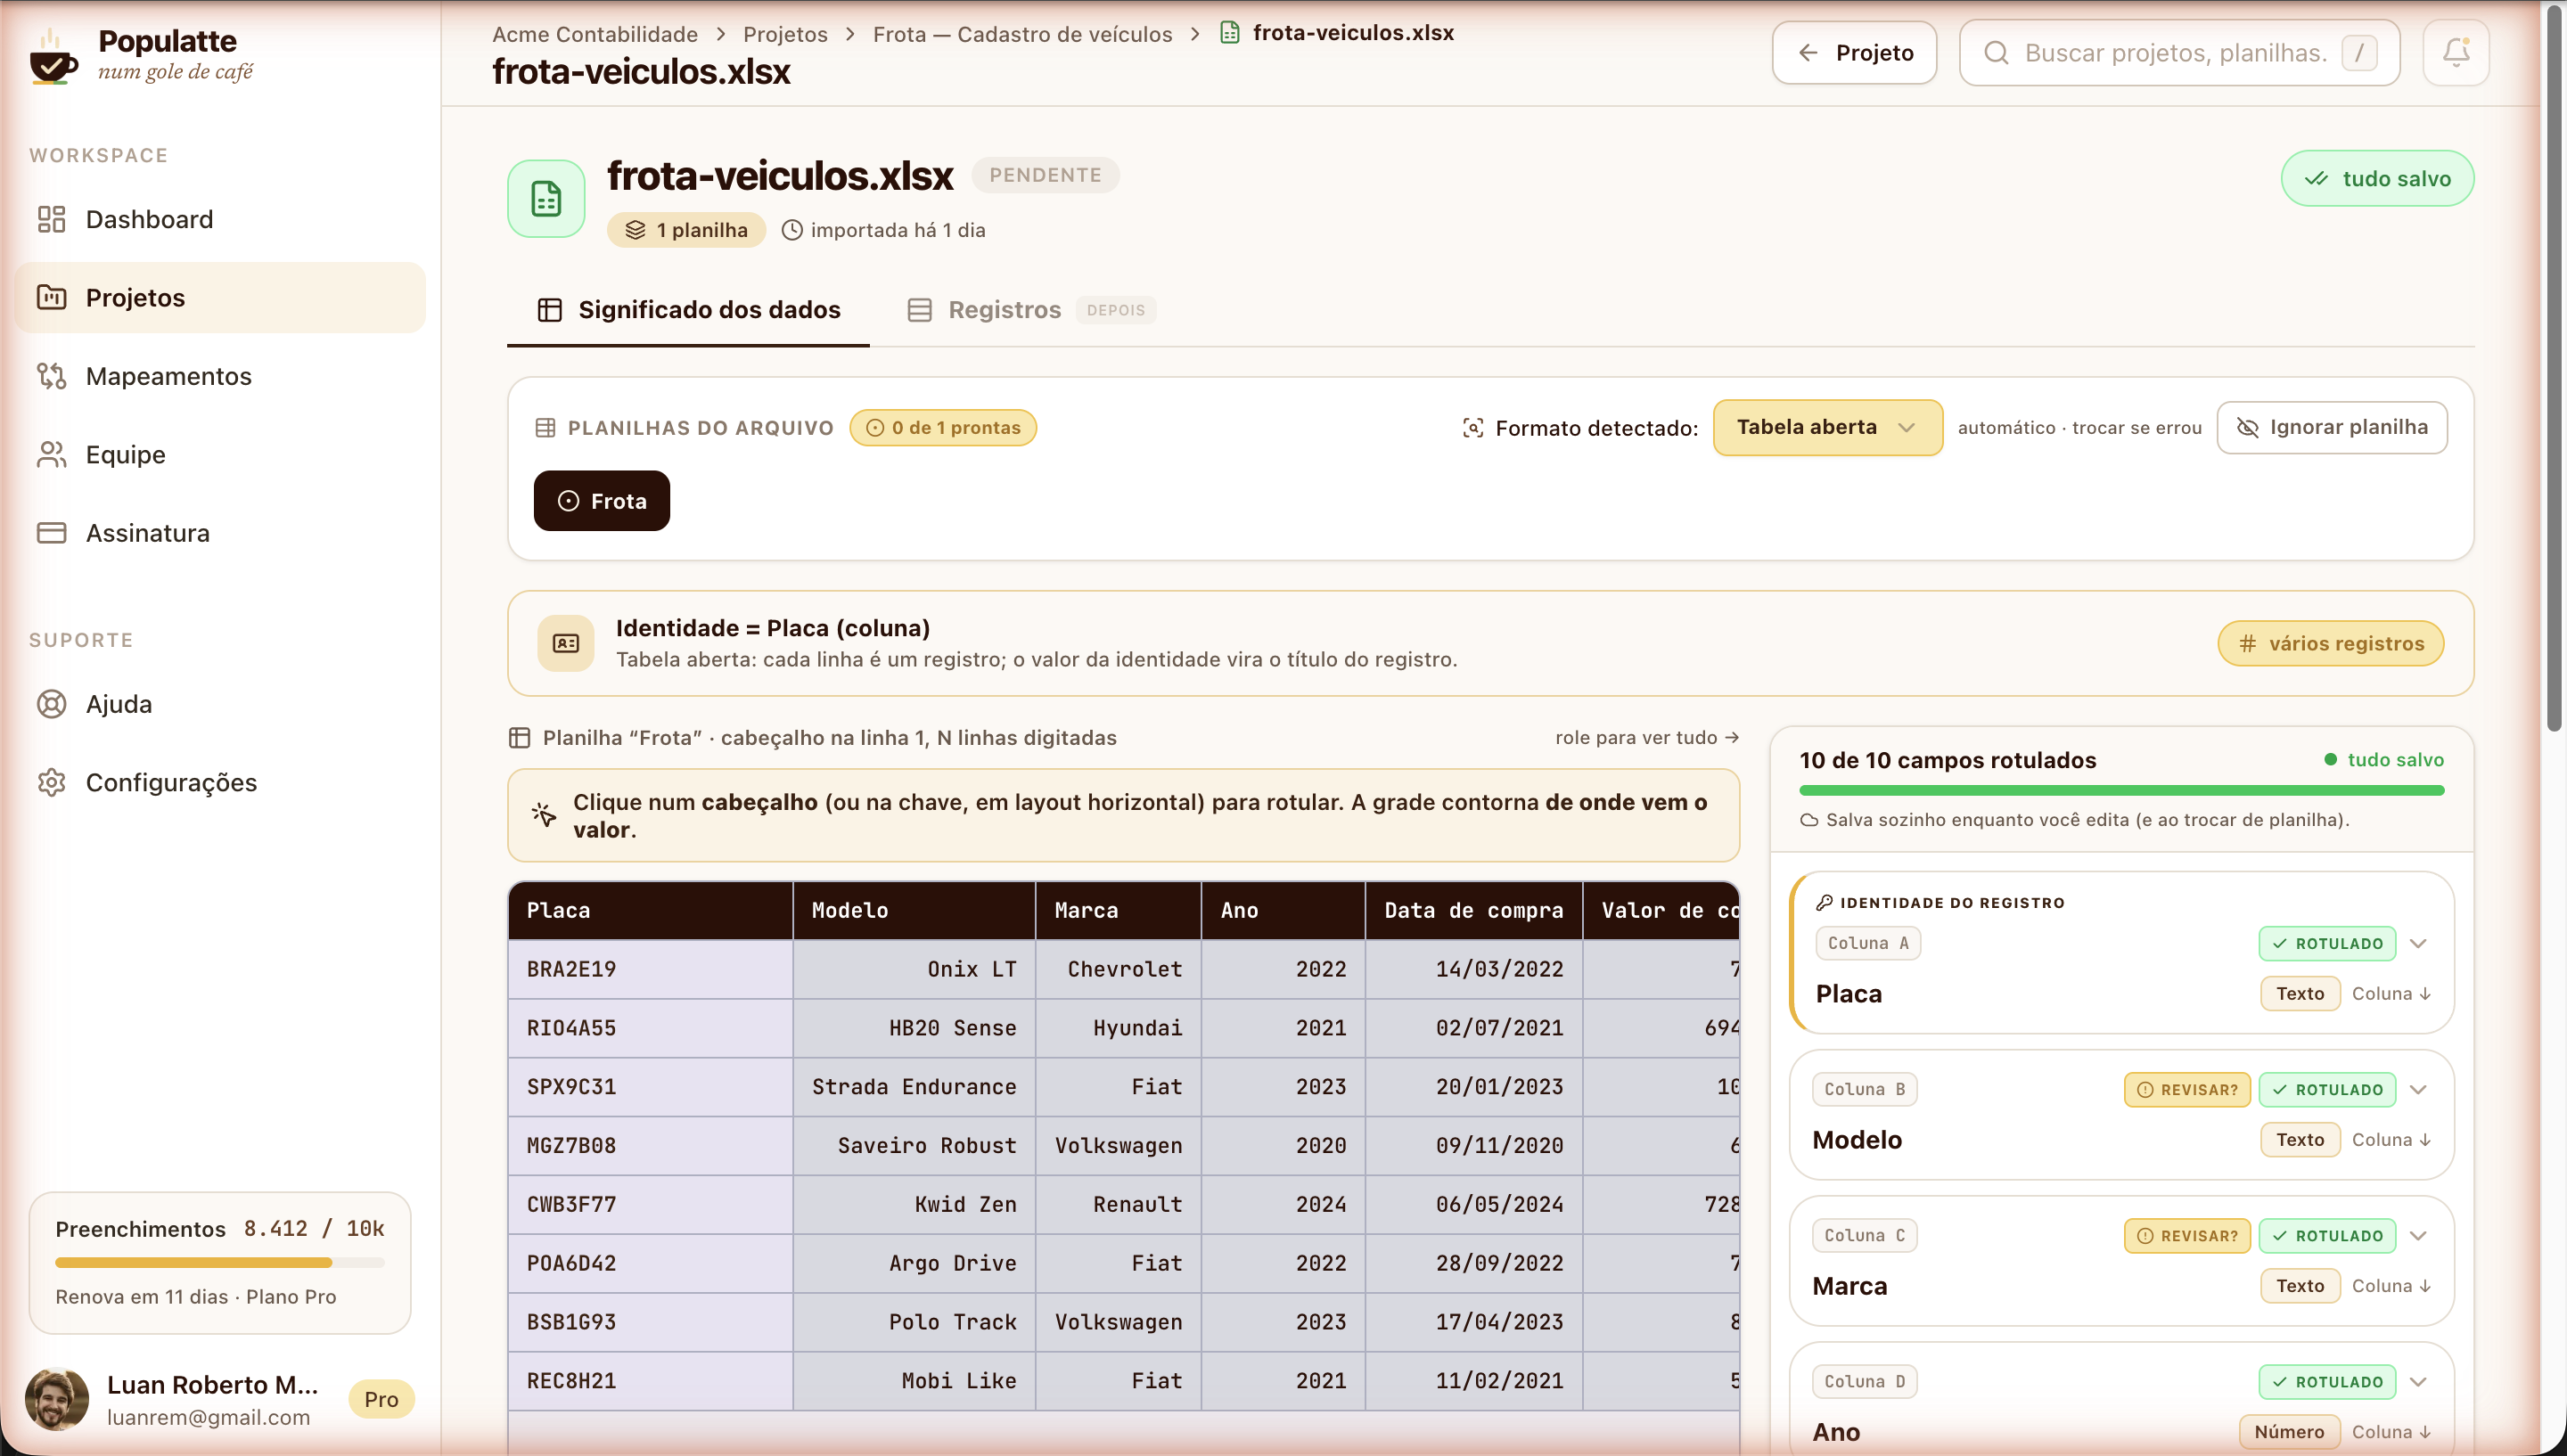
Esta é a tela que mais consumiu tempo de projeto, e é ela que responde à primeira pergunta. Quando uma planilha entra, o sistema tenta descobrir sozinho o formato de cada aba (é uma matriz mensal? uma tabela comum? uma lista transposta?), o que cada coluna é e de onde vem o valor de cada campo. Cada proposta vem com um nível de confiança, e o que ficou abaixo do limiar aparece marcado com um "revisar?" em vez de fingir certeza. Célula com erro de fórmula não conta como evidência de tipo; ela vira motivo para pedir revisão.
A separação que eu demorei a enxergar é entre tipo e formato. O tipo é o que a célula é: texto, número, data, booleano. O formato é como ela se mostra: moeda, porcentagem, data, contábil, as mesmas doze categorias da janela de formatar células do Excel, porque essa é a linguagem que a pessoa do outro lado já fala. R$ 78.990,00 é um número que aparece como moeda. Tratar moeda como tipo parece funcionar até o dia em que você precisa somar dois.
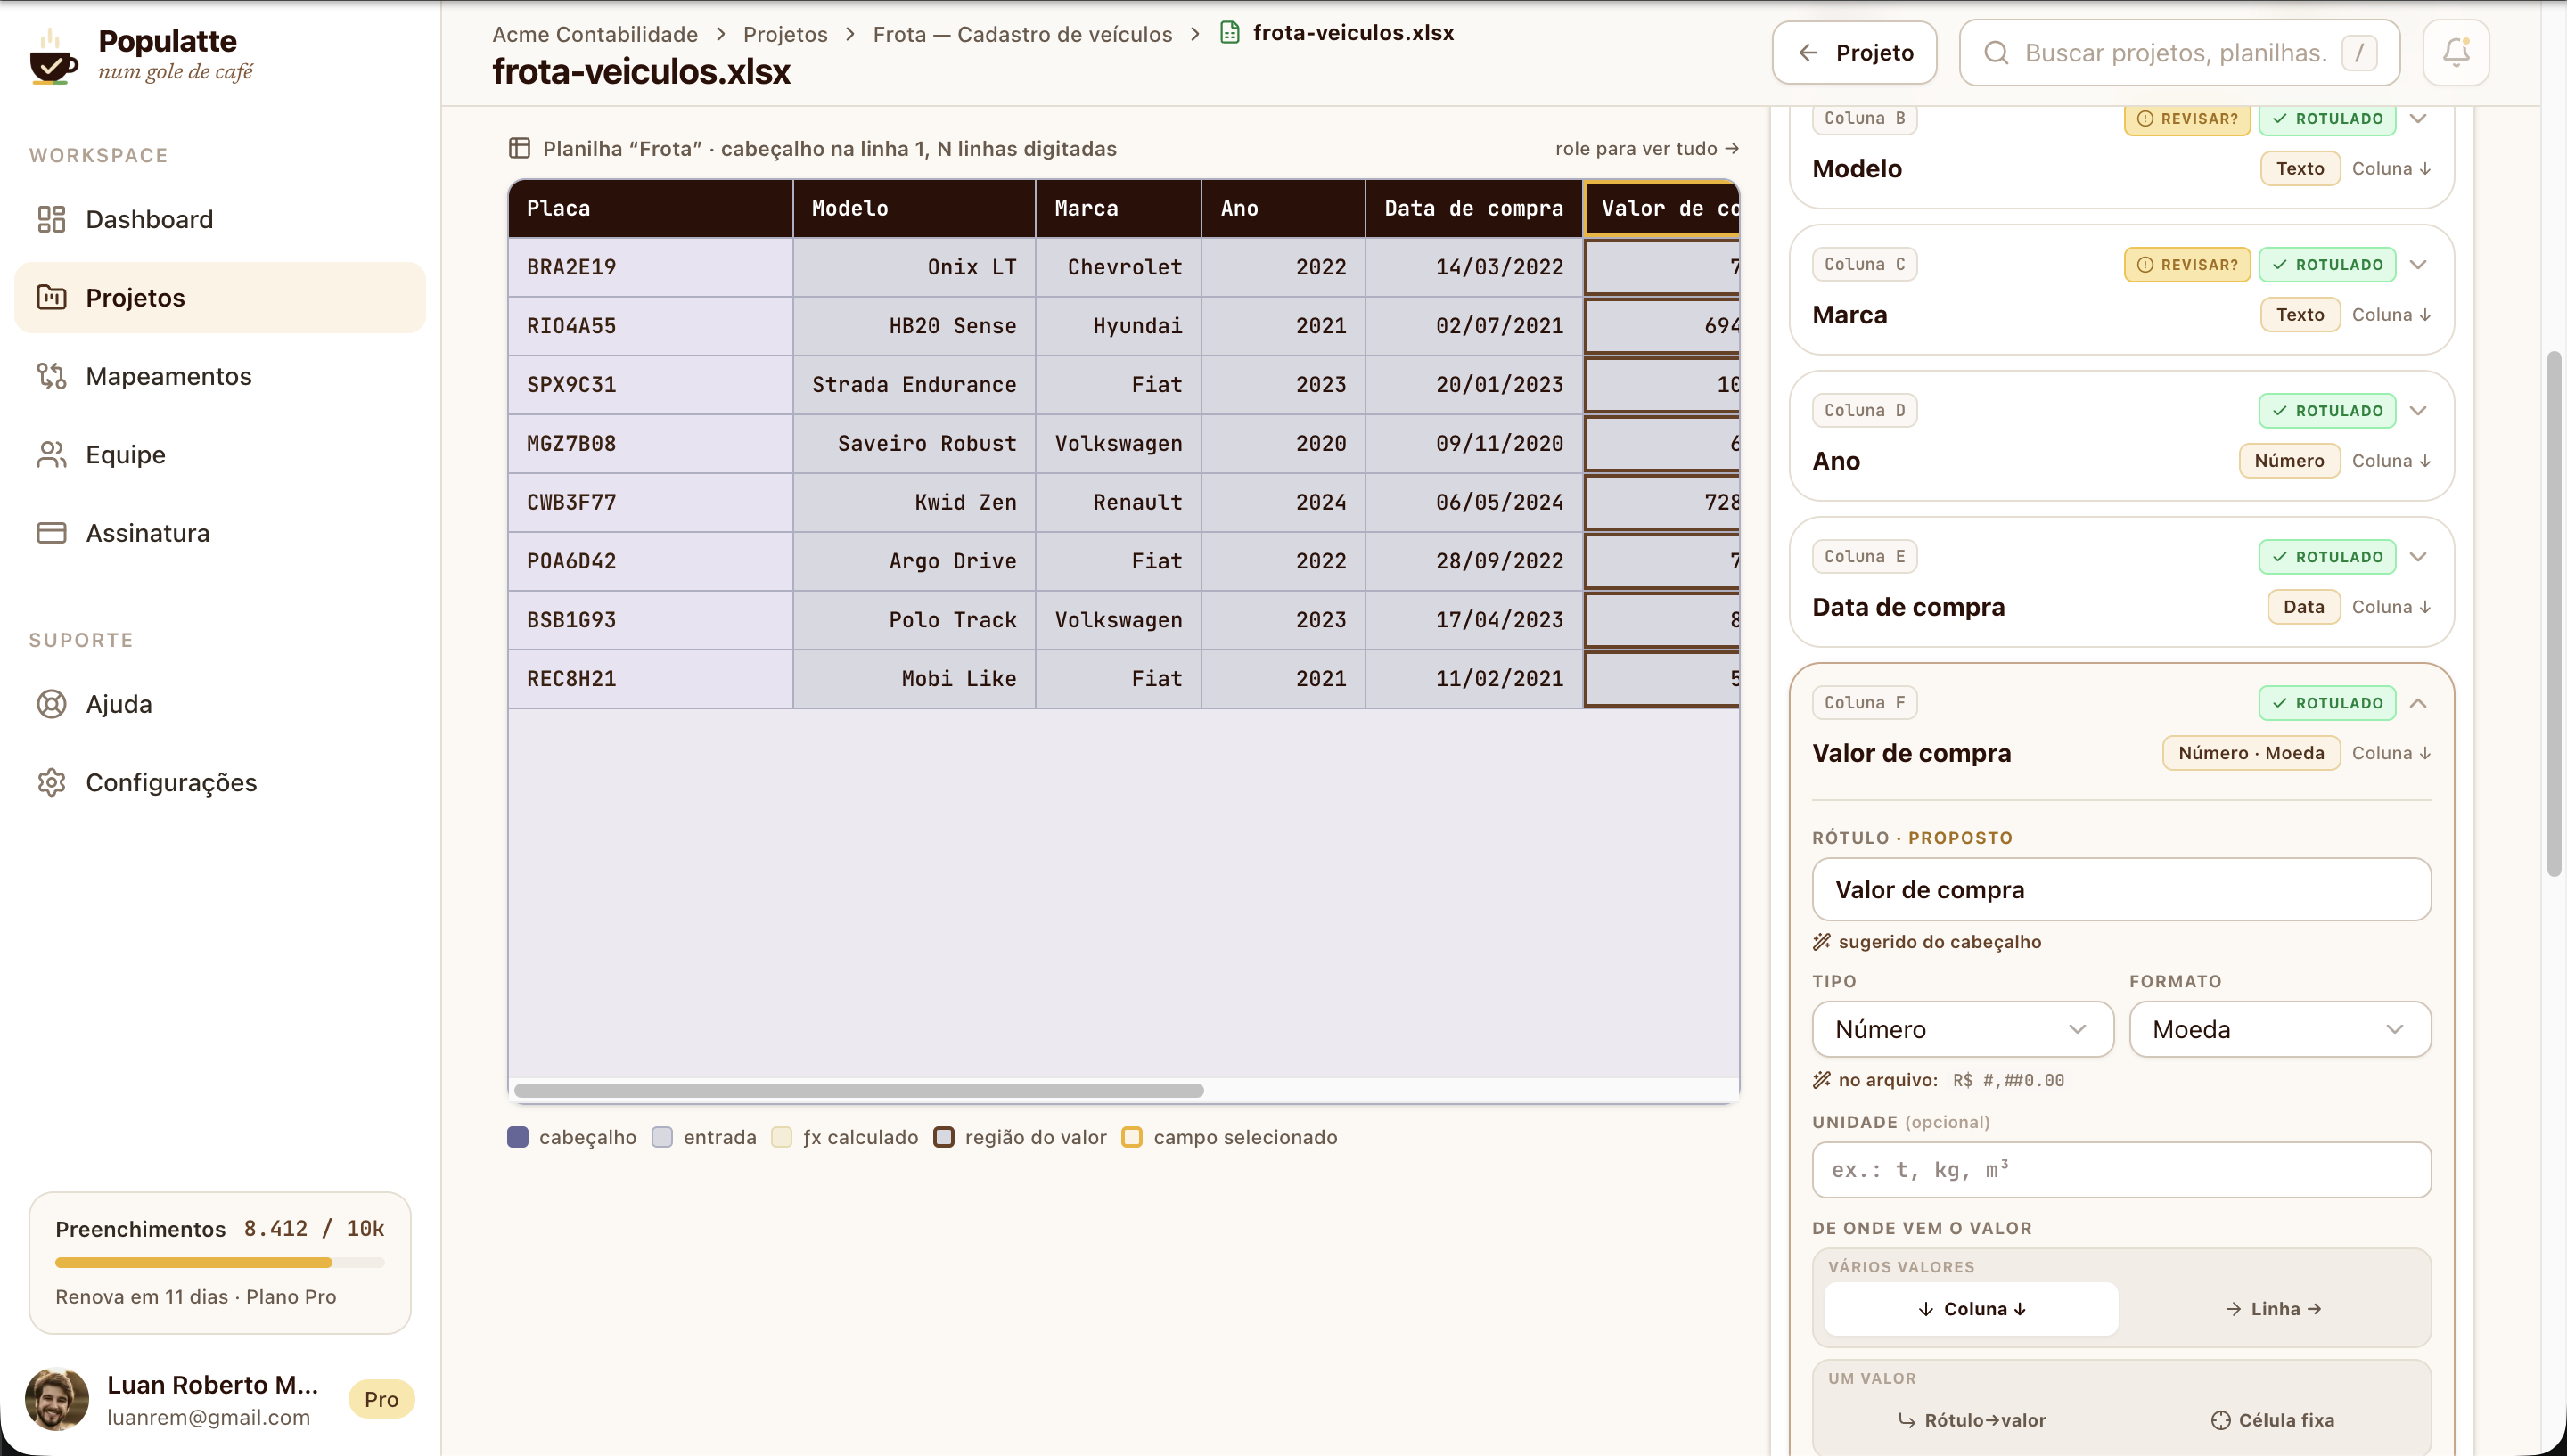
Quando tudo está rotulado, o resultado vira um template do projeto, ancorado no texto dos cabeçalhos. No próximo upload da mesma planilha, se a assinatura do arquivo bater exatamente, o significado é reaplicado sozinho, e o mês seguinte não recomeça do zero. Se não bater, ele não tenta adivinhar: volta para a detecção e deixa a pessoa decidir. E a edição salva sozinha enquanto você digita, porque nessa tela ninguém deveria ter que lembrar de botão de salvar.
Uma decisão sustenta tudo isso: cada coluna ganha uma chave normalizada no momento da ingestão, e essa chave nunca muda. Ela é o único fio ligando o dado guardado, o significado que a pessoa deu e o passo de preenchimento lá na ponta. Não tem chave estrangeira garantindo isso, então a imutabilidade é garantida por invariante de domínio e por schema estrito na borda.
Escrever num DOM que não é meu
O preenchimento acontece ao vivo, campo a campo, na página real. Nada de gerar arquivo para importar no site: o formulário é a fonte da verdade, e é nele que a pessoa confere. Isso significa que o executor precisa lidar com o mundo como ele é:
- Decimal em português.
1500.5precisa virar1500,5. Mas sem separador de milhar e sem casas fixas, porque o mesmo caminho carrega um ano (2024) e um número de documento, e formatar bonito ali destruiria o dado. - Rádio por valor. Uma coluna com
+ou-precisa marcar o botão certo dentro do grupo. Ele procura pelo atributovaluee, se não achar, tenta o texto do rótulo associado. - Campos que não percebem que foram preenchidos. Escrever direto em
.valuenão avisa o React, e o valor some no próximo render. A escrita usa o setter nativo do protótipo e dispara os eventos que a página espera, o que funciona tanto num formulário moderno quanto num portal legado. - Seletores que envelhecem. Na captura, o seletor é gerado ignorando classes de framework e classes com hash, que mudam a cada build, e cada passo guarda um alternativo. Antes de preencher, o painel valida cada seletor contra a página aberta e mostra quais não encontrou. Um mapeamento que aponta em silêncio para um campo que não existe mais é pior do que mapeamento nenhum.
Passos podem ser opcionais; um passo obrigatório que falha aborta o resto e devolve exatamente qual passo quebrou e por quê. O registro é marcado como erro, com a mensagem, em vez de contar como feito.
Conectar a extensão sem compartilhar sessão
Extensão não compartilha cookie com o dashboard, e eu não ia pedir a senha de ninguém dentro de um painel lateral. O fluxo é um código de pareamento: logado no dashboard, você gera um código de seis dígitos e digita na extensão, que troca esse código por um token próprio. O código vale cinco minutos, é de uso único, gerar um novo invalida o anterior, e erros seguidos bloqueiam as tentativas por um tempo.
Um detalhe que eu gostei: a API aceita dois tipos de token, o do Clerk e o da extensão. Em vez de tentar validar para ver o que acontece, o guard olha o algoritmo no cabeçalho do token e já sabe de quem é. Isso evita erro no log e uma verificação que nunca daria certo.
Como eu testo isso sem depender do site do governo
Testar um motor de preenchimento é chato pelo motivo esperado: o alvo é um site que não é meu, que exige login e que eu definitivamente não quero martelar com teste automatizado.
A solução foi um laboratório offline em Playwright. Ele empacota o executor real da extensão, o mesmo arquivo que roda em produção, não uma cópia, e roda contra formulários servidos localmente. Um deles é uma réplica offline de um formulário de governo de verdade, gerada por um script a partir de uma página salva, com os scripts removidos e os postbacks neutralizados, preservando o HTML esquisito e os acentos. São sete cenários rodando hoje, cobrindo justamente as regras que dão medo: decimal em português, rádio por valor, passo obrigatório que falha e aborta o resto.
O resto da API tem teste de unidade e de integração em Jest, concentrado onde tem regra: detecção de formato, prontidão de uma aba, a imutabilidade da chave, a reaplicação do template. O banco local sobe em Docker, então qualquer máquina tem o mesmo Postgres.
Onde está hoje
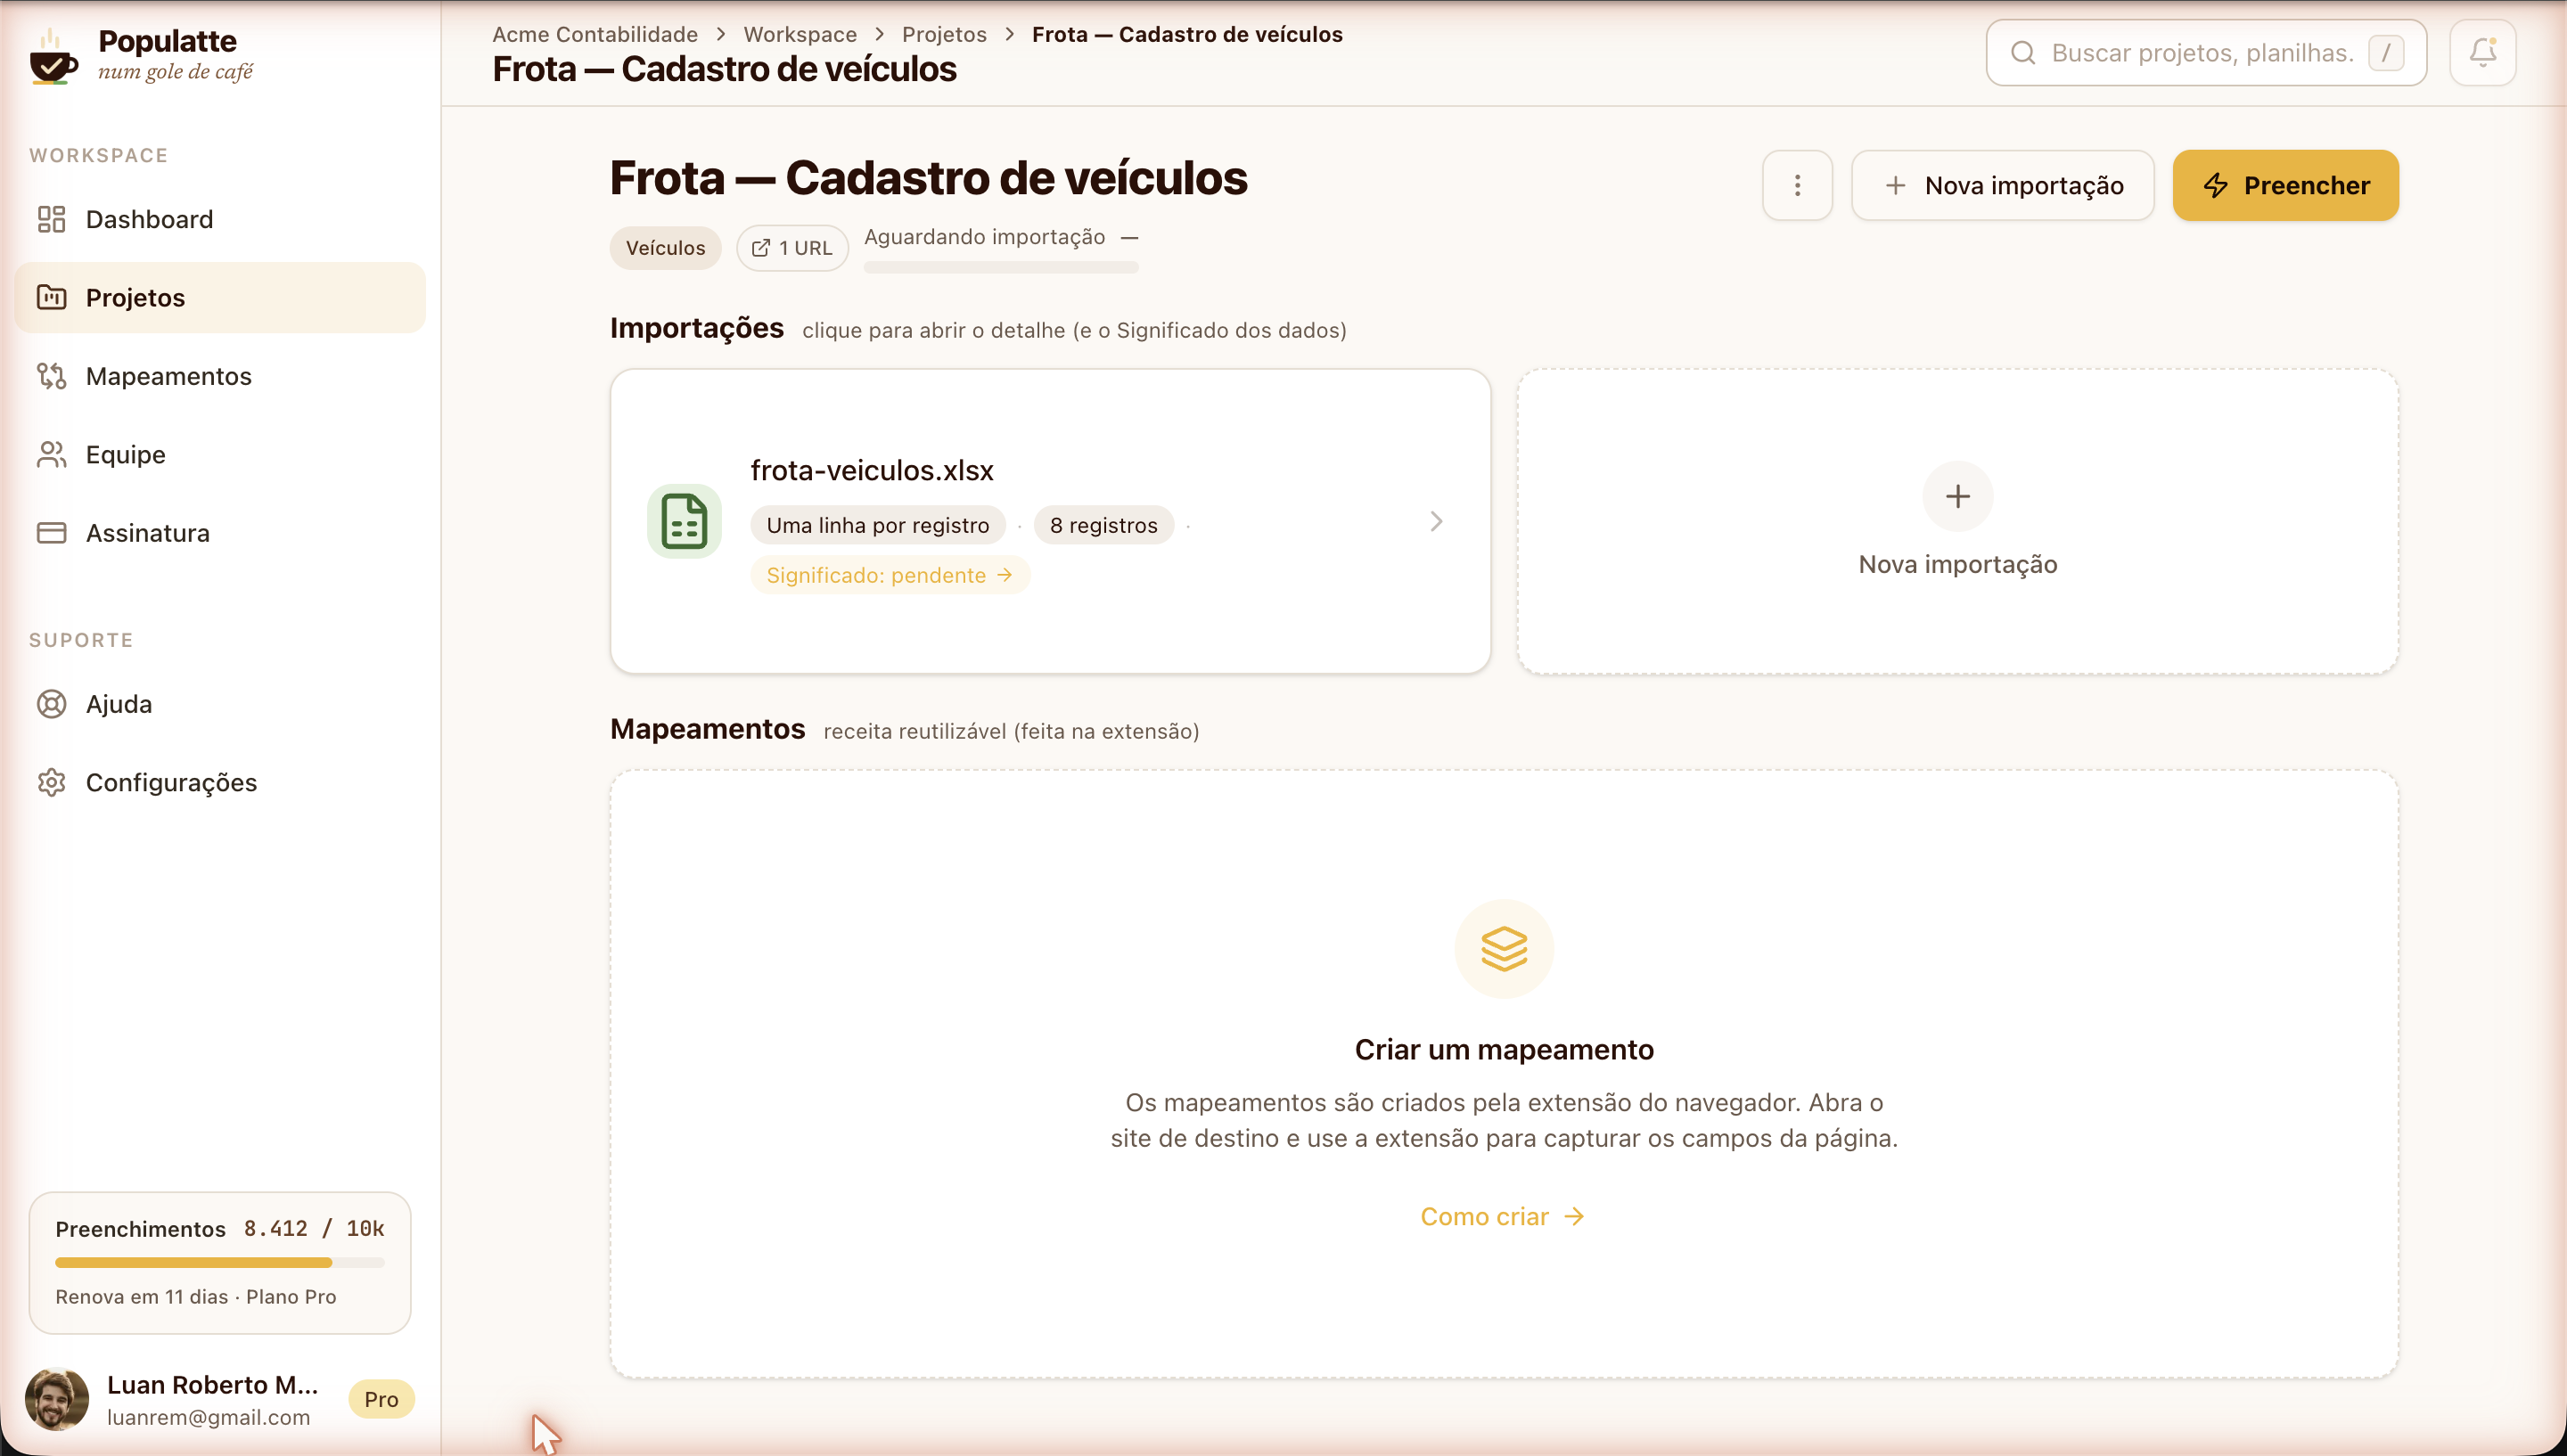
Funciona de ponta a ponta, na minha máquina, com dados reais: subir a planilha, descobrir o formato, rotular os campos, capturar os campos do formulário pela extensão e preencher o registro. Isso já foi validado num formulário de teste e contra a réplica offline do formulário real.
O que ainda não existe: não está publicado, ninguém de fora usou, e várias telas do dashboard ainda são só placeholder (equipe, assinatura, o painel geral). A extensão funciona, mas ainda não passou por design; a interface dela é estrutura, não acabamento. Também não tem cobrança nem plano de assinatura de verdade ainda.
E, para ser transparente sobre o ritmo de agora: estou viajando pela Europa. Não é um projeto abandonado, é um projeto andando a passos lentos.
O que vem a seguir
Deploy e um MVP na frente de gente de verdade, com meta de fechar até dezembro de 2026. A ordem é: publicar, colocar a primeira usuária real preenchendo os formulários dela de ponta a ponta, e só então olhar para o que eu adiei. Nessa lista estão o preenchimento de formulários que recarregam a página a cada passo, os grupos de passos repetíveis para tabelas e a garantia de não enviar o mesmo registro duas vezes.
Depois disso, e só depois, o piloto automático.